AIエージェントが使える社内データ
合意したAI業務に社内の記録をつなぎます。データソース、品質チェック、権限を明確にし、出典をたどれる最初の回答を提供します。
AIを使う業務が、必要な社内記録を信頼できる経路で取得できるようにします。関連するソースを整理し、各項目の意味を明確にし、データを接続し、お客様とアクセスルールを定めます。最初の納品物は、合意した一つの問いに対する、出典をたどれる記録に基づく回答と、データ品質および権限の検査です。
写真: Falkenpost / Pixabay 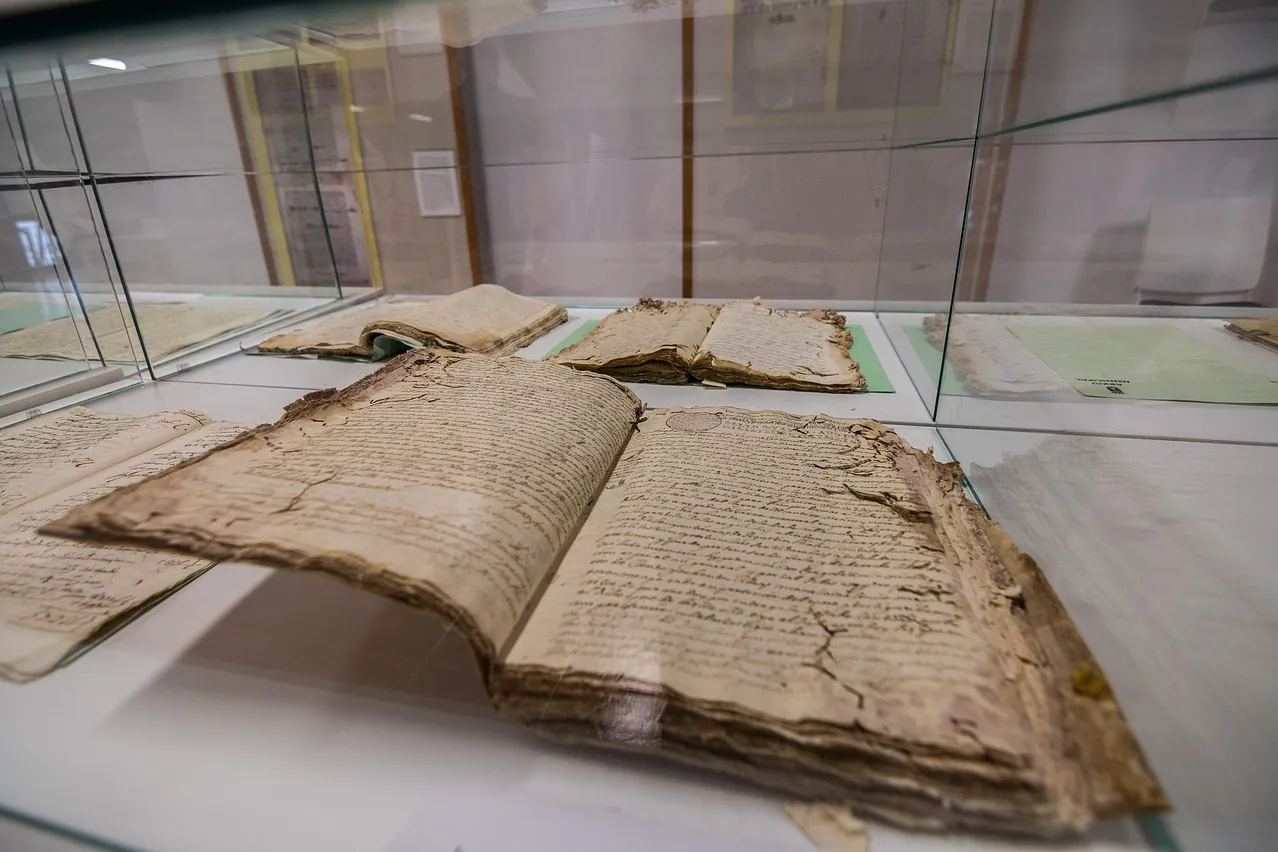
写真: JoanjoCastello / Pixabay
集約する:エージェントがアクセスできる一か所へ
システムを結び付けるパイプラインを構築します。定期実行し、変更分だけを読み込み、何を読み飛ばしたかを報告するETL処理で、データベースに取り込みます。そのスキーマには、顧客、注文、船舶、契約、案件といった、お客様の事業の言葉を使います。古いPDF、スキャン文書、メールアーカイブを検索可能なテキストに変換し、出典と一緒に保持して、保存するだけでなく見つけられるようにします。エージェントは、仕様を記述した一つの窓口、MCPサーバーまたはAPIから全体にアクセスします。誰かのノートパソコン上のデータベースのコピーを、アクセスの窓口にはしません。
整える:同じ顧客を五人にしない
同じ顧客が、五つのシステムに五通りの名前で登録されることがあります。同じ事実について矛盾する記録を読む場合、エージェントには、どの出典を信頼するかを決めるルールが必要です。私たちは、それぞれの事実の正本とするシステムをお客様と決め、確認できるルールで重複を統合し、その処理を継続します。新たな重複は、次の監査まで待たず、次の読み込みで検出します。データベースの型と制約は不正な行の保存を拒否し、各列には意味を記載します。また、すべてのマイグレーションをバージョン管理して検査し、エージェントが読むスキーマを、デプロイされているスキーマと一致させます。
権限を設ける:利用者に許された範囲だけを見せる
何でも読めるエージェントは、親しみやすい声で話す情報漏えいの経路です。ルールはプロンプトではなくデータに組み込みます。データベースのロール(RBAC)、原則として読み取り専用、ある顧客に別の顧客のデータを見せてはいけない箇所での行単位のルール、業務に必要な場合を除く個人データへのアクセス禁止を設けます。これはGDPRが求めることでもあります。エージェントは、管理者ではなく利用者の権限で動作し、すべての読み取りで、どの利用者に代わって行ったかを記録します。エージェント自体の保護については、別のページで説明しています。
エージェントの答えの正確さは 読み込むデータに左右されます — だから、すべての回答に出典を示すべきです。
出典をたどれ、データの変換過程が文書化されていれば、AIの回答を評価しやすくなります。
すべての回答から出典をたどれるようにする
社内データに基づく回答の価値は、出典の価値に左右されるため、出典も一緒に渡します。各行には、どこから、いつ取り込んだかを、システム、読み込み処理、ファイル、ページとともに保持します。エージェントは数値の根拠となる記録を引用でき、人はそれを開けます。行を読み飛ばした処理は、成功と報告するだけでなく、件数と理由を示します。数値に誤りが見つかれば、一週間推測を重ねるのではなく、その数値を取り込んだ処理までたどれます。私たち自身のレポートも同じルールに基づいています。その実行で測定していない数値は、出力しません。
取り組みを裏付ける実績
このページの記述はすべて、実際に使った方法であり、それぞれに記録があります。SQLとデータモデルを修正して、地理データパイプラインを50倍高速化し、BigQuery、MS SQL、PostgreSQLにまたがる六つのETL・ELTパイプラインを設計・運用しました。34スキーマにわたる348テーブルで一つの業種全体をモデル化し、1,022のマイグレーションを通じて、ずれを検出する品質ゲートでスキーマの整合性を維持しました。読み取り専用のSQLiteエクスポートから495ページを生成し、963の構造化データブロックを一つのつながったグラフに置き換えました。このサイトでエージェントが最初に読むのも、そのグラフです。
ご依頼の進め方
まず、変更を加えずに、どのシステムが何を持ち、誰が責任を持ち、エージェントがどの問いに答えるべきかを整理します。次に、最も重要な問いを一つ選び、ソース、整備、権限、窓口まで、最初から最後までの経路を構築します。データにずれが生じたら読み込みを止める検査も備えます。その後、次の問いに進みます。すべてはお客様のインフラとリポジトリに置き、お客様のレビューを通して進めます。データを読むエージェントには、業種に合わせて構築するものも、すでにお使いのものも使えます。他の仕事と同じく、料金に記載する条件でご依頼いただけます。
担当者が必要とする答えが、誰も全容を把握できないほど各所に散らばっている場合は、データの所在をお聞かせください。
エージェントに必要な答えは すでに社内のシステムにあります — 読み取れる形に整える必要があります。
まず、どのシステムに何があるかを、変更を加えずに整理し、お客様にとって最も重要な問いを一つ定めます。