Unternehmensdaten bereit für KI-Agenten
Unternehmensdaten für einen vereinbarten KI-Ablauf: klare Quellen, Qualitätsprüfungen, Berechtigungen und ein erstes nachvollziehbares Ergebnis.
Geben Sie einem KI-Arbeitsablauf einen zuverlässigen Zugang zu den benötigten Unternehmensdaten. Wir erfassen die relevanten Quellen, klären die Bedeutung jedes Felds, verbinden die Daten und legen mit Ihnen Zugriffsregeln fest. Das erste Ergebnis ist die Antwort auf eine vereinbarte Frage aus nachvollziehbaren Datensätzen, mit Prüfungen der Datenqualität und Berechtigungen.
Foto: Falkenpost / Pixabay 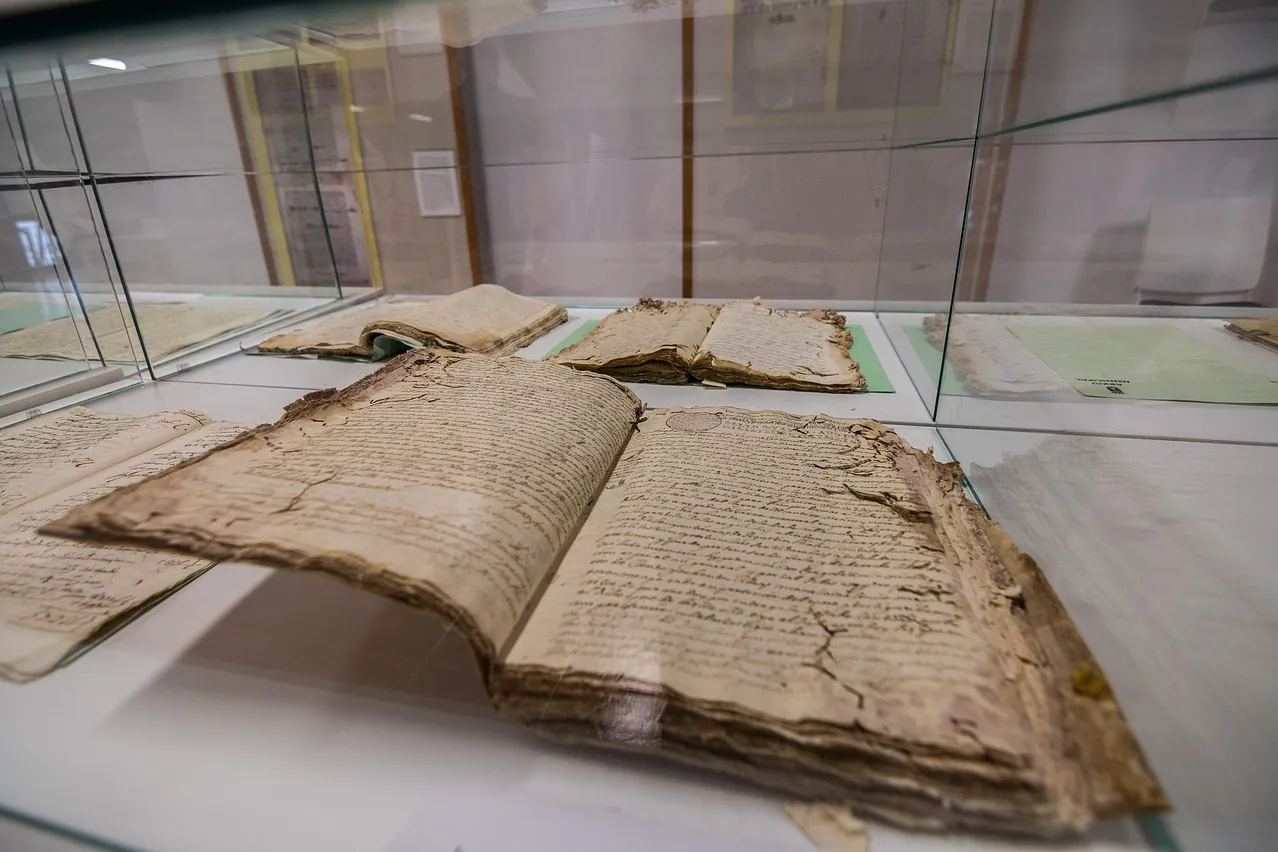
Foto: JoanjoCastello / Pixabay
Die Leistung in ein Ergebnis überführen
Machen Sie „Unternehmensdaten bereit für KI-Agenten“ für ein Geschäftsergebnis nutzbar. Wir können die technische Arbeit mit den Nutzern, Betriebsabläufen und Entscheidungen verbinden, die sie unterstützen soll. Ihre Datensätze sind für KI-Agenten erreichbar, jeder Kunde ist nur einmal erfasst, niemand sieht mehr als erlaubt und jede Antwort lässt sich bis zur Quelle zurückverfolgen.
Die passenden Arbeiten prüfen
Prüfen Sie unser Vorgehen anhand der zugehörigen Arbeiten auf dieser Seite. Fragen Sie nach den Abwägungen und den Bedingungen hinter jedem Ergebnis.
Zusammengeführt: an einem für Agenten erreichbaren Ort
Wir entwickeln die Pipelines, die Ihre Systeme zusammenführen: zeitgesteuerte ETL-Jobs, die nur Änderungen laden und ausgelassene Daten ausweisen. Ziel ist eine Datenbank, deren Schema Ihr Geschäft in Ihren Begriffen beschreibt — Kunden, Aufträge, Schiffe, Verträge, Fälle. Alte PDFs, Scans und E-Mail-Archive werden in durchsuchbaren Text umgewandelt und zusammen mit ihrer Quelle aufbewahrt, damit sie auffindbar sind, statt nur gespeichert zu werden. Der Agent erreicht alles über einen beschriebenen Zugang: einen MCP-Server oder eine API, niemals über eine Datenbankkopie auf dem Laptop einer Person.
Bereinigt: ein Kunde statt fünf
Derselbe Kunde kann in fünf Systemen in fünf Schreibweisen stehen. Liest ein Agent widersprüchliche Fassungen derselben Tatsache, braucht er eine Regel dafür, welcher Quelle er vertrauen soll. Wir legen mit Ihnen je Information das maßgebliche System fest, führen Dubletten nach lesbaren Regeln zusammen und halten den Abgleich am Laufen. So wird eine neue Dublette beim nächsten Laden erkannt statt erst bei der nächsten Prüfung. Typen und Constraints in der Datenbank weisen einen ungültigen Datensatz zurück, statt ihn zu speichern. Jede Spalte benennt ihre Bedeutung, jede Migration wird versioniert und geprüft. So liest ein Agent genau das Schema, das auch bereitgestellt ist.
Berechtigt: jeder Agent sieht, was sein Benutzer sehen darf
Ein Agent, der alles lesen kann, ist ein Datenleck mit freundlicher Stimme. Die Regeln gehören in die Daten, nicht in den Prompt: Rollen in der Datenbank (RBAC), standardmäßig nur Lesezugriff, Regeln auf Zeilenebene, wo ein Kunde niemals die Daten eines anderen sehen darf, und personenbezogene Daten außer Reichweite, sofern die Aufgabe sie nicht benötigt — wie es auch die DSGVO verlangt. Der Agent handelt mit den Rechten seines Benutzers, niemals mit Administratorrechten. Jeder Lesezugriff wird mit der Person protokolliert, für die er erfolgte. Die Absicherung der Agenten selbst beschreibt eine eigene Seite.
Ein Agent ist nur so korrekt wie die Daten, die er liest — deshalb sollte jede Antwort ihre Herkunft nennen.
Nachvollziehbare Quellen und dokumentierte Transformationen erleichtern die Beurteilung einer KI-Antwort.
Jede Antwort auf ihre Quelle zurückführen
Eine Antwort aus Unternehmensdaten ist so gut wie ihre Quelle; deshalb wird diese mitgeführt. Jede Zeile hält fest, woher sie stammt und wann sie eingelesen wurde: System, Ladevorgang, Datei und Seite. Ein Agent kann den Datensatz hinter einer Zahl zitieren, und ein Mensch kann ihn öffnen. Ein Ladevorgang mit ausgelassenen Zeilen nennt Anzahl und Grund, statt schlicht Erfolg zu melden. Eine fehlerhafte Zahl führt zum verantwortlichen Ladevorgang statt zu einer Woche Rätselraten. Auf dieser Regel beruht auch unser eigenes Berichtswesen: Keine Zahl wird ausgegeben, die der Lauf nicht gemessen hat.
Die Arbeit dahinter
Jede Aussage auf dieser Seite beschreibt eine von uns eingesetzte Methode, und jede ist dokumentiert. Wir haben eine geografische Datenpipeline 50-mal schneller gemacht, indem wir SQL und Datenmodell korrigiert haben, und sechs ETL- und ELT-Pipelines konzipiert und betrieben, über BigQuery, MS SQL und PostgreSQL hinweg. Wir haben eine ganze Branche in 348 Tabellen über 34 Schemas modelliert und dieses Schema über 1.022 Migrationen hinweg mit einer Drift-Prüfung konsistent gehalten. Wir haben 495 Seiten aus einem schreibgeschützten SQLite-Export erzeugt und 963 Blöcke strukturierter Daten durch einen verknüpften Graphen ersetzt, den ein Agent auf dieser Website zuerst liest.
So läuft ein Auftrag ab
Am Anfang steht eine Bestandsaufnahme mit reinem Lesezugriff: Welche Systeme enthalten was, wer ist jeweils verantwortlich und welche Fragen soll ein Agent beantworten können? Dann nehmen wir die wichtigste Frage und bauen ihren Weg vollständig auf — Quellen, Bereinigung, Berechtigungen und Zugang — mit Prüfungen, die den Ladevorgang bei Datenabweichungen stoppen. Danach folgt die nächste Frage. Alles liegt in Ihrer Infrastruktur und Ihrem Repository und durchläuft Ihre Prüfung. Die lesenden Agenten können für Ihre Branche entwickelt werden oder bereits bei Ihnen im Einsatz sein. Die Beauftragung erfolgt wie bei unseren übrigen Leistungen zu den unter Was es kostet beschriebenen Bedingungen.
Wenn die Antworten für Ihre Mitarbeiter an mehr Orten liegen, als jemand aufzählen kann, sagen Sie uns, wo Ihre Daten liegen.
Die Antwort, die Ihr Agent benötigt, liegt bereits in Ihren Systemen — sie muss lesbar aufbereitet werden.
Es beginnt mit einer rein lesenden Bestandsaufnahme, welche Systeme welche Daten enthalten, und der einen Frage, die Ihnen am wichtigsten ist.